По заявлению разработчиков, модель объединяет понимание текста, изображений, аудио и видео с возможностью планировать задачи и вызывать внешние инструменты для их выполнения.

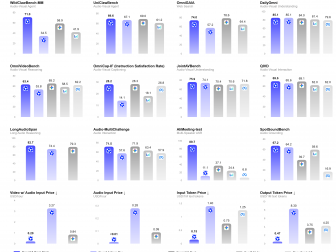
По заявлению разработчиков, модель объединяет понимание текста, изображений, аудио и видео с возможностью планировать задачи и вызывать внешние инструменты для их выполнения.


