
источники Google
Nvidia представила ИИ-модель Nemotron 3.5 Transcribe с открытыми весами. Она предназначена для распознавания речи, перевода и анализа аудиозаписей, поддерживает русский язык и способна обрабатывать записи длительностью до часа. Вместе с моделью компания выпустила набор данных для обучения и инструменты для её адаптации под специализированные задачи.
Nemotron 3.5 Transcribe распознаёт речь на 40 языках, переводит с 31 языка на английский и обратно, а также определяет говорящих на 13 языках. Модель работает с записями, в которых участвуют до восьми человек, включая диалоги с перебиваниями.
С помощью текстовых инструкций можно получить транскрипцию с указанием спикеров, перевод, краткое изложение принятых решений или ответы на вопросы по содержанию записи. Пользователь также может передать модели подсказки с техническими терминами, например названиями лекарств.
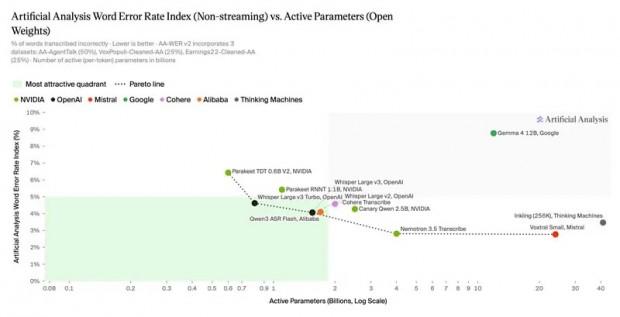
Общее число параметров модели достигает 30 млрд, но при обработке каждого фрагмента задействовано около 4 млрд. Благодаря этому Nemotron 3.5 Transcribe способна работать даже на одной видеокарте Nvidia, включая компактную DGX Spark. На флагманской RTX PRO 6000 Blackwell Server Edition модель обрабатывает 100 часов аудио менее чем за три минуты в формате NVFP4.
В рейтинге Open ASR Leaderboard на Hugging Face модель заняла первое место среди решений с открытыми весами со средней долей ошибок распознавания слов 5,33%. В независимом бенчмарке Artificial Analysis её показатель составил 2,81% — почти на уровне Mistral Voxtral Small с результатом 2,77%, хотя у последней примерно в шесть раз больше активных параметров.
Особенно сильные результаты модель показала в определении говорящих. В тесте VoiceArena, где сравнивались 14 систем на записях с одновременной речью нескольких участников, Nemotron 3.5 Transcribe заняла первое место: доля пропущенных слов составила 8,32% против медианных 31% у конкурентов. В тесте David AI, оценивающем точность диаризации на 21 языке, модель также стала лучшей, незначительно опередив специализированную Nemotron 3 Diarization.
Одновременно Nvidia представила набор данных Granary v2 объёмом около 844 тысяч часов аудио на 48 языках. Предыдущая версия включала примерно 643 тысячи часов речи на 25 языках. Записи доступны в разных вариантах расшифровки: дословной, с сохранением слов-паразитов и с числами, записанными словами.
Компания также добавила инструменты для подготовки датасетов и дообучения модели под конкретные сферы. Например, после адаптации на медицинских записях с участием индийских врачей и студентов-медиков частота ошибок снизилась с 30,8 до 11,8%. На новых, незнакомых модели голосах показатель уменьшился с 22,44 до 12,17%.
Nemotron 3.5 Transcribe и Granary v2 уже доступны на Hugging Face. Nvidia также опубликовала демонстрационную версию и руководство по дообучению, включая расширение, позволяющее поручить этот процесс ИИ-ассистенту для программирования. Возможности модели зависят от языка. Кроме того, система рассчитана на обработку готовых записей, а не потокового аудио, поэтому Nvidia рекомендует дополнительно проверять имена участников и моменты смены говорящих.




Горячие темы