
Xiaomi представила открытую модель искусственного интеллекта CocktailASR-1. Она предназначена для расшифровки речи в условиях, когда несколько людей говорят одновременно, и умеет выделять голос конкретного собеседника из общей аудиозаписи.
Как работает CocktailASR-1
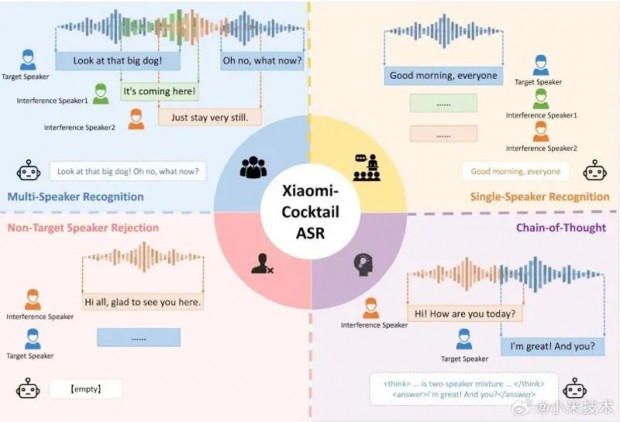
В Xiaomi назвали эту проблему «эффектом коктейльной вечеринки». Большинство моделей распознавания речи демонстрируют хорошие результаты, когда в записи говорит только один человек. Однако при одновременных репликах нескольких собеседников голоса накладываются друг на друга: слова и предложения искажаются, а отдельные фразы могут ошибочно приписываться другим участникам разговора.
Для работы с CocktailASR-1 пользователю необходимо предоставить короткий аудиофрагмент с голосом нужного человека. Модель использует эту запись в качестве образца, а затем анализирует разговор с несколькими участниками и расшифровывает только речь выбранного собеседника.
В отличие от представленной ранее модели OmniVoice, предназначенной для генерации речи и копирования голоса, CocktailASR-1 не синтезирует аудио, а выделяет и преобразует речь в текст.
Результаты тестирования
По данным Xiaomi, в тестах на распознавание речи при одновременном звучании нескольких голосов CocktailASR-1 показала одни из лучших результатов и превзошла существующие модели, созданные для решения аналогичных задач.
При этом возможности системы не ограничиваются сложными многоголосными записями. Она способна расшифровывать речь и в тех случаях, когда на аудио присутствует только один человек.
Разработчики также предусмотрели защиту от ошибочных предположений. Если голос, предоставленный в качестве образца, отсутствует в записи, модель вернет пустой текст, а не станет расшифровывать речь другого собеседника.
Кроме того, CocktailASR-1 поддерживает режим цепочки рассуждений. Он позволяет пользователю ознакомиться с логикой, на основании которой модель выполнила расшифровку, а не только получить готовый текст.
Модель доступна на GitHub и Hugging Face.




Горячие темы